
צפו בסרטון: ניתוח נתונים עם AI בשלוש דקות
איך עוברים ממקורות מידע מפוזרים לשיחה עם הנתונים? הסבר קצר על מחסן נתונים, הכנת המידע והשכבה הסמנטית שמאפשרת ל־AI להשיב על שאלות עסקיות בצורה אמינה.
בשנים האחרונות ארגונים משקיעים לא מעט בניסיון להכניס AI לתהליכי העבודה שלהם. אחד התחומים המעניינים ביותר הוא ניתוח דאטה AI – האפשרות לקחת את המידע העסקי של הארגון ולאפשר למנהלים ולעובדים לשאול עליו שאלות בשפה רגילה.
במקום לפתוח מערכת BI, לבחור דוח, לסמן פילטרים ולנסות להבין גרף, מנהל יכול פשוט לשאול: "מה היו המכירות שלנו החודש לעומת החודש המקביל?" "איזה סוכן מכירות השתפר הכי הרבה השנה?" "אילו מוצרים נמצאים בירידה?" "מהם חמשת הלקוחות שהגדילו הכי הרבה את הרכישות?"
מבחינת המשתמש זה נראה פשוט מאוד. מאחורי הקלעים, כדי שהמערכת תחזיר תשובה נכונה ולא רק תשובה שנשמעת משכנעת, נדרש תהליך מסודר של הכנת הנתונים, מידול והגדרת המשמעות העסקית שלהם.
במאמר הזה נראה בצורה פשוטה כיצד תהליך כזה יכול לעבוד באמצעות PostgreSQL כ־Data Warehouse, שימוש ב־Sling Data וב־dbt להכנת המידע, ולאחר מכן כלי כגון Credible או SimmAI לצורך בניית שכבה סמנטית ותשאול הנתונים באמצעות AI.
שלב ראשון: מביאים את המידע למקום אחד
כמעט בכל ארגון הנתונים מפוזרים. המכירות נמצאות במערכת ERP, פרטי הלקוחות ב־CRM, פעילות האתר במערכת אחרת, ולעיתים קיימים גם קבצי Excel, מערכות ענן, APIs ומערכות פנימיות שנבנו במיוחד עבור החברה. לפני שמתחילים לדבר על AI, צריך קודם ליצור בסיס מידע מסודר.
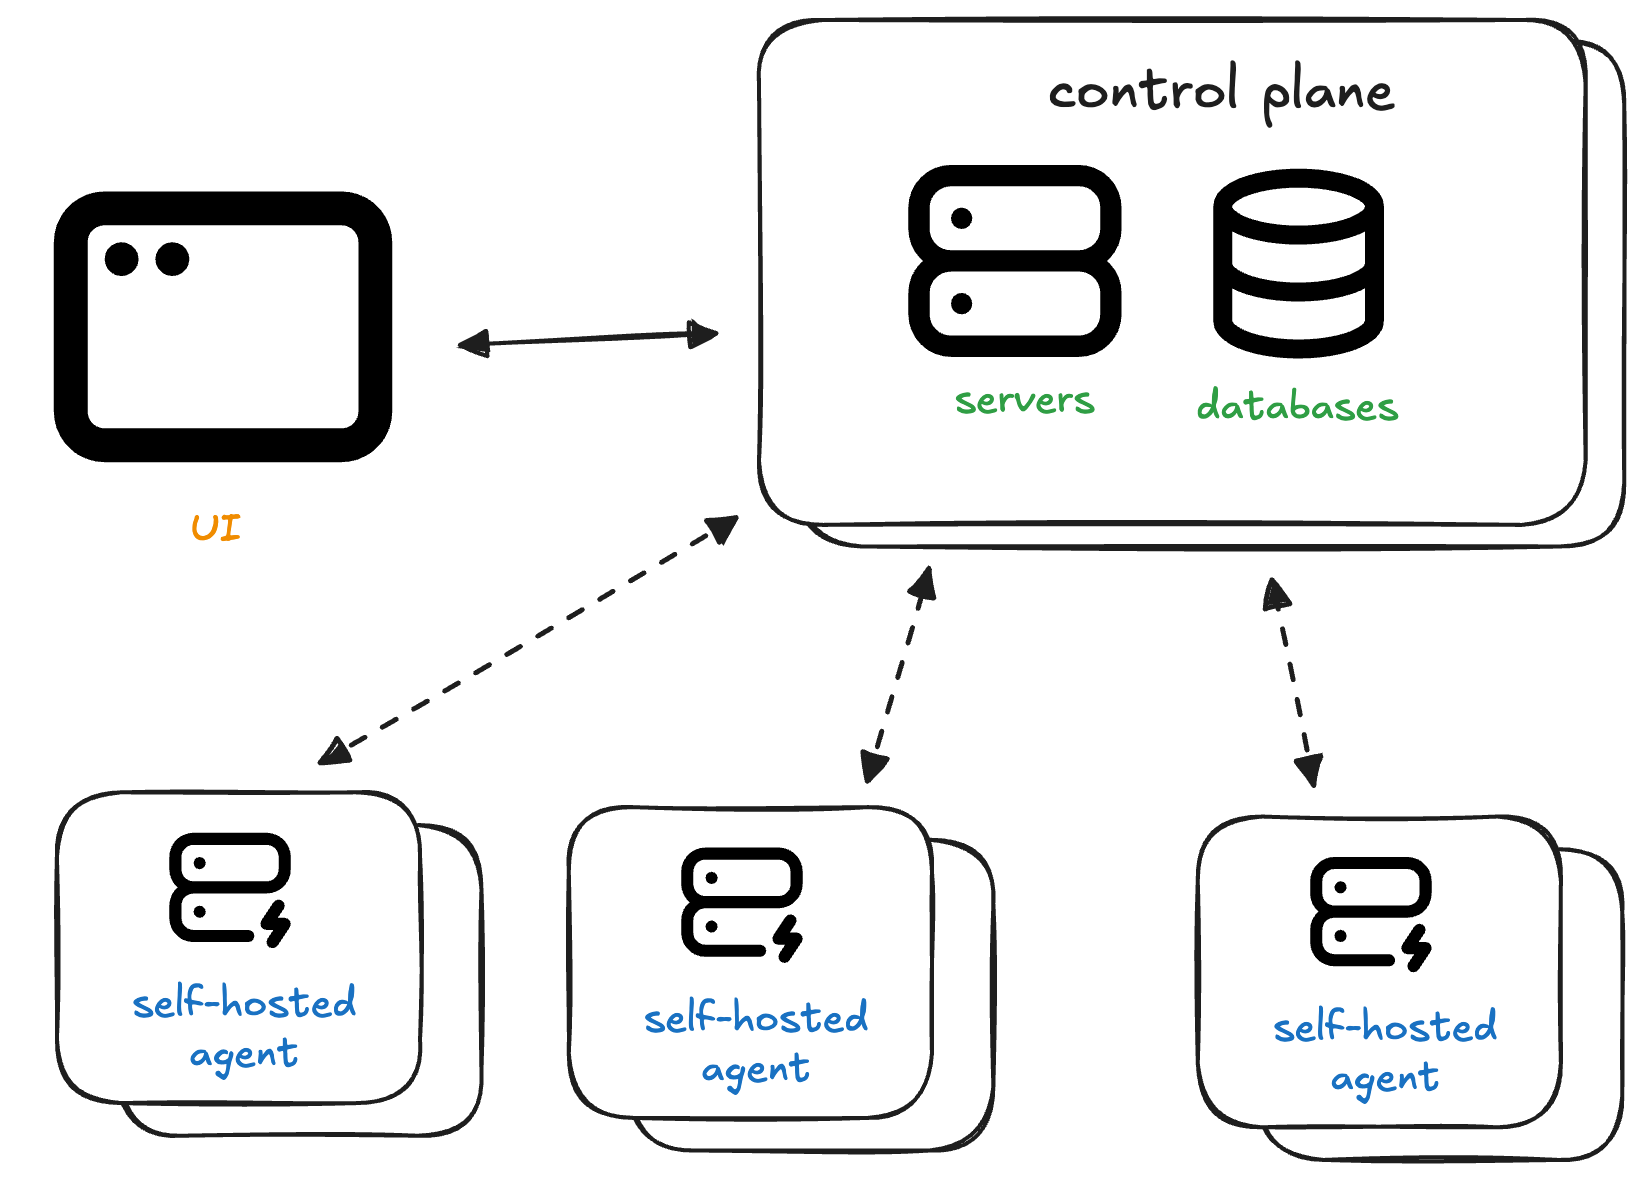
בתרחיש פשוט ניתן להקים Data Warehouse על גבי PostgreSQL ולרכז אליו את המידע הרלוונטי. כלי כמו Sling Data יכול לשמש להעברת הנתונים ממערכות המקור אל PostgreSQL. Sling תומך בתהליכי Replication בין בסיסי נתונים ובטעינה מלאה או אינקרמנטלית, כך שאין צורך בכל הרצה להעתיק מחדש את כל המידע.
לדוגמה, נניח שיש לנו חברה העוסקת במכירת ציוד. במערכת שלה קיימים נתוני מכירות, טבלת פריטים וטבלת סוכני מכירות. בנוסף קיימת מערכת CRM עם פרטי הלקוחות. בעזרת Sling ניתן להעביר את הטבלאות הרלוונטיות ל־PostgreSQL בתהליך קבוע שמתבצע, לדוגמה, אחת לשעה או מספר פעמים ביום. המטרה בשלב הזה פשוטה:
להביא את הנתונים למקום מרכזי שאנחנו שולטים בו.
זו עדיין אינה מערכת ניתוח דאטה AI. זהו הבסיס שעליו היא תיבנה.
שלב שני: מסדרים את הדאטה עם dbt
העובדה שהנתונים נמצאים במקום אחד עדיין לא אומרת שהם מוכנים לניתוח. במערכת המקור יכולה להיות טבלת חשבוניות, טבלת שורות חשבונית, טבלת החזרות וטבלת לקוחות. ייתכן ששדה המחיר כולל מע"מ במקום אחד ולא כולל מע"מ במקום אחר.
ייתכן שסוכן המכירות מופיע באמצעות מספר עובד ואילו במערכת אחרת באמצעות כתובת אימייל. לכן השלב הבא הוא Data Transformation. כאן ניתן להשתמש ב־dbt.
dbt מאפשר להגדיר מודלים באמצעות SQL ולבנות מהם טבלאות או Views מסודרים בתוך מחסן הנתונים. כל מודל הוא למעשה הגדרה של הדרך שבה אנחנו רוצים שהמידע העסקי ייראה לאחר העיבוד. לדוגמה, במקום לתת למערכות שמעל ה־DWH לעבוד ישירות מול עשרות טבלאות של מערכת ה־ERP, אפשר להכין מספר מבנים פשוטים יותר:
טבלת מכירות מסודרת. טבלת פריטים. טבלת לקוחות. טבלת סוכנים. וטבלאות עזר כגון תאריכים, אזורים וקבוצות מוצרים. בשלב הזה כבר אפשר להחליט כיצד מטפלים בזיכויים, אילו עסקאות נחשבות למכירה ואיזה תאריך הוא התאריך הקובע לצורך הדוחות. אבל עדיין חסר לנו משהו חשוב.
הנתונים מסודרים – אבל האם ה-AI מבין אותם?
נניח שב־Data Warehouse קיימות שלוש טבלאות עיקריות: Sales, Items ו־Agents. מבחינה טכנית אפשר לתת ל־ChatGPT או למודל AI אחר גישה לטבלאות ולבקש ממנו לכתוב SQL. אבל אז המשתמש שואל: "כמה מכר כל סוכן השנה?" המערכת צריכה לדעת מהי מכירה. האם מדובר בסכום ההזמנה? בסכום החשבונית? האם מורידים החזרות?
האם המחיר כולל מע"מ? מה קורה אם העסקה בוטלה? איזה שדה מחבר בין המכירה לסוכן? ומהי בכלל "השנה" – שנה קלנדרית או שנת הכספים של החברה? זה ההבדל בין גישה לבסיס נתונים לבין ניתוח דאטה AI אמיתי.
כדי לקבל תשובות שניתן לסמוך עליהן, המערכת צריכה להבין לא רק היכן הנתונים נמצאים, אלא גם מה הם אומרים.
כאן נכנסת השכבה הסמנטית
כלי כגון Credible מאפשר להוסיף שכבת משמעות מעל הנתונים. Credible מבוסס על Malloy, שפת מידול נתונים בקוד שבה ניתן להגדיר מקורות, Dimensions, Measures, קשרים בין טבלאות וכללי גישה. המודל הופך את מבנה בסיס הנתונים למושגים עסקיים שהן בני אדם והן סוכני AI יכולים להבין.
לדוגמה, עבור חברת המכירות שלנו נוכל להגדיר: "מכירות" הן סכום שורות החשבוניות לאחר הפחתת זיכויים וללא מע"מ. "סוכן" הוא העובד שאליו משויכת העסקה בעת ביצוע המכירה. "פריט פעיל" הוא מוצר שלא סומן כלא פעיל.
"לקוח חדש" הוא לקוח שביצע את הרכישה הראשונה שלו בתקופה שנבחרה. בנוסף מוגדרים הקשרים. כל מכירה קשורה לפריט. כל מכירה קשורה ללקוח. כל מכירה משויכת לסוכן. כל פריט שייך לקבוצת מוצרים. כעת כאשר המשתמש שואל שאלה, ה־AI אינו צריך לנחש כיצד לחבר את הטבלאות או כיצד לחשב את המדדים.
המשמעות כבר קיימת במודל. Credible מתארת את הגישה הזאת כמודל שבו ההגדרות העסקיות, המדדים והקשרים מוגדרים פעם אחת, ולאחר מכן משמשים את כלי ה־AI, הדוחות והאפליקציות שמעליהם.
ועכשיו אפשר פשוט לשאול
לאחר שהמידע נמצא ב־PostgreSQL והשכבה הסמנטית מוגדרת, מגיע החלק שהמשתמש רואה. מנהל המכירות יכול לשאול: "מי שלושת הסוכנים עם המכירות הגבוהות ביותר מתחילת השנה?" המערכת יודעת מהו סוכן, מהן מכירות ומה משמעות התקופה. לאחר מכן אפשר לשאול:
"עבור הסוכן במקום הראשון, אילו פריטים תרמו הכי הרבה לגידול?" ואז: "השווה אותו לשנה שעברה." או: "האם העלייה נובעת מכמות גדולה יותר של עסקאות או מגידול בגודל העסקה הממוצעת?" זה כבר הרבה יותר מדוח. זהו תהליך חקירה.
וזה לדעתי אחד היתרונות הגדולים של ניתוח דאטה AI: המשתמש אינו צריך לדעת מראש איזה דוח הוא רוצה. הוא מתחיל משאלה, רואה תשובה וממשיך לשאלה הבאה.
Credible מאפשרת לעבוד עם המודל דרך סביבת האנליזה שלה וגם להעמיד אותו לרשות סוכני AI באמצעות MCP ו־APIs. לפי התיעוד שלה, אותו מודל יכול לשמש לשיחה עם הנתונים, לדוחות, לאפליקציות ולסוכני AI, כאשר כללי הגישה נשמרים כחלק מהמודל.

האם חייבים בכלל Data Warehouse?
מעניין לציין ש־Credible עצמה אינה מחייבת Data Warehouse. המוצר יכול להתחבר גם למידע שנמצא במקורות אחרים ומציג גישה שבה ניתן לעבוד ללא Warehouse נפרד. הוא גם תומך בחיבור ל־Postgres ולפלטפורמות נתונים אחרות. למרות זאת, בארגונים רבים אנחנו ב־Inflow נעדיף עדיין להתחיל משכבת נתונים מסודרת. הסיבה פשוטה.
Data Warehouse אינו נועד רק עבור AI. הוא מאפשר לייצר מקום מרכזי למידע הארגוני, לבצע ניקוי, לשמור היסטוריה, לחבר בין מערכות שונות ולרכז את הלוגיקה המורכבת לפני שמגיעים לשכבת התשאול. במקרים אחרים ניתן לבחור בארכיטקטורה שונה.
הבחירה תלויה בכמות הנתונים, מספר המקורות, מורכבות הלוגיקה, דרישות האבטחה וצורת השימוש של הארגון.
Credible, SimmAI או פתרון אחר?
Credible היא דוגמה טובה לגישה שבה המודל הסמנטי עומד במרכז. במקרים אחרים אפשר להשתמש בפתרונות כגון SimmAI או במערכות אחרות המאפשרות למשתמשים לתשאל את המידע העסקי בשפה טבעית. המוצר עצמו הוא רק חלק מהפתרון. החלק החשוב יותר הוא לבנות נכון את כל השרשרת: מקורות המידע צריכים להיות מחוברים.
הנתונים צריכים להיות נקיים. הקשרים צריכים להיות נכונים. המדדים צריכים להיות מוגדרים. ההרשאות צריכות להתאים למשתמש. ורק אז כדאי לתת ל־AI להתחיל לענות. אחרת אנחנו מקבלים מערכת מרשימה מאוד שיודעת לענות במהירות – אבל לא בהכרח נכון.
כאן נמצאת המומחיות של Inflow
ב־Inflow אנחנו עוסקים בדיוק בחיבור שבין העולמות האלה. מצד אחד Data Engineering: חיבור למערכות ERP, CRM, APIs, קבצים ומקורות מידע אחרים, הקמת Data Warehouse ובניית תהליכי ELT באמצעות כלים כגון Sling Data ו־dbt.
מצד שני Data Analytics: הבנת הלוגיקה העסקית, מידול הנתונים, הגדרת מדדים, הרשאות ושכבה סמנטית. ומעל כל אלה – ניתוח דאטה AI, שמאפשר למשתמש העסקי לקבל את המידע באמצעות שיחה טבעית במקום להיות תלוי בכל פעם בפיתוח של דוח נוסף. המטרה מבחינתנו אינה להכניס AI משום שזהו הנושא החם של התקופה.
המטרה היא לבנות מערכת שבה ה־AI באמת מבין את הנתונים של הארגון. כאשר מחברים נכון את שלושת החלקים – Data Warehouse מסודר, שכבה סמנטית טובה וממשק AI – אפשר לשנות משמעותית את הדרך שבה מנהלים ועובדים צורכים מידע. במקום לחכות לדוח, הם שואלים. במקום לחפש את הגרף הנכון, הם מבקשים את התשובה.
ובמקום שמודל ה־AI ינחש כיצד העסק עובד, אנחנו מלמדים אותו מראש מה הנתונים באמת אומרים.
זה מבחינתנו הכיוון שאליו הולך עולם ניתוח דאטה AI: פחות דוחות קשיחים, יותר שיחה עם המידע – אבל על בסיס תשתית נתונים נכונה והגדרות עסקיות שניתן לסמוך עליהן.
